

Google Gemini가 잘하는 것
- 대화 및 텍스트 생성: ComfyUI 워크플로 내에서 직접 Google의 멀티모달 AI와 대화할 수 있습니다.
- 멀티모달 추론: Gemini의 추론 기능으로 이미지를 해석합니다.
- 이미지-프롬프트 해석: 공식 템플릿에는 이미지를 해당하는 그림 프롬프트로 변환하는 프롬프트가 포함되어 있습니다.
- 다중 이미지 입력:
Batch Images를 사용하면 한 번의 실행으로 여러 이미지를 AI 해석에 보낼 수 있습니다.
사용 방법
코드에서 호출하기
Comfy Router를 통해 HTTP로 호출하세요. 복사해 붙여넣기만 하면 되는 Python, TypeScript, cURL 스니펫을 제공합니다
Google Gemini
Gemini의 추론 기능으로 Google의 멀티모달 AI를 경험해 보세요.
Comfy Cloud에서 실행
Comfy Cloud에서 열기
워크플로 다운로드
JSON을 다운로드하거나 템플릿 라이브러리에서 “Google Gemini”를 검색하세요
LoadImage 노드에 업로드하세요:
example.png
LoadImage 노드 2 · example.png
워크플로 실행을 단계별로 완료하기
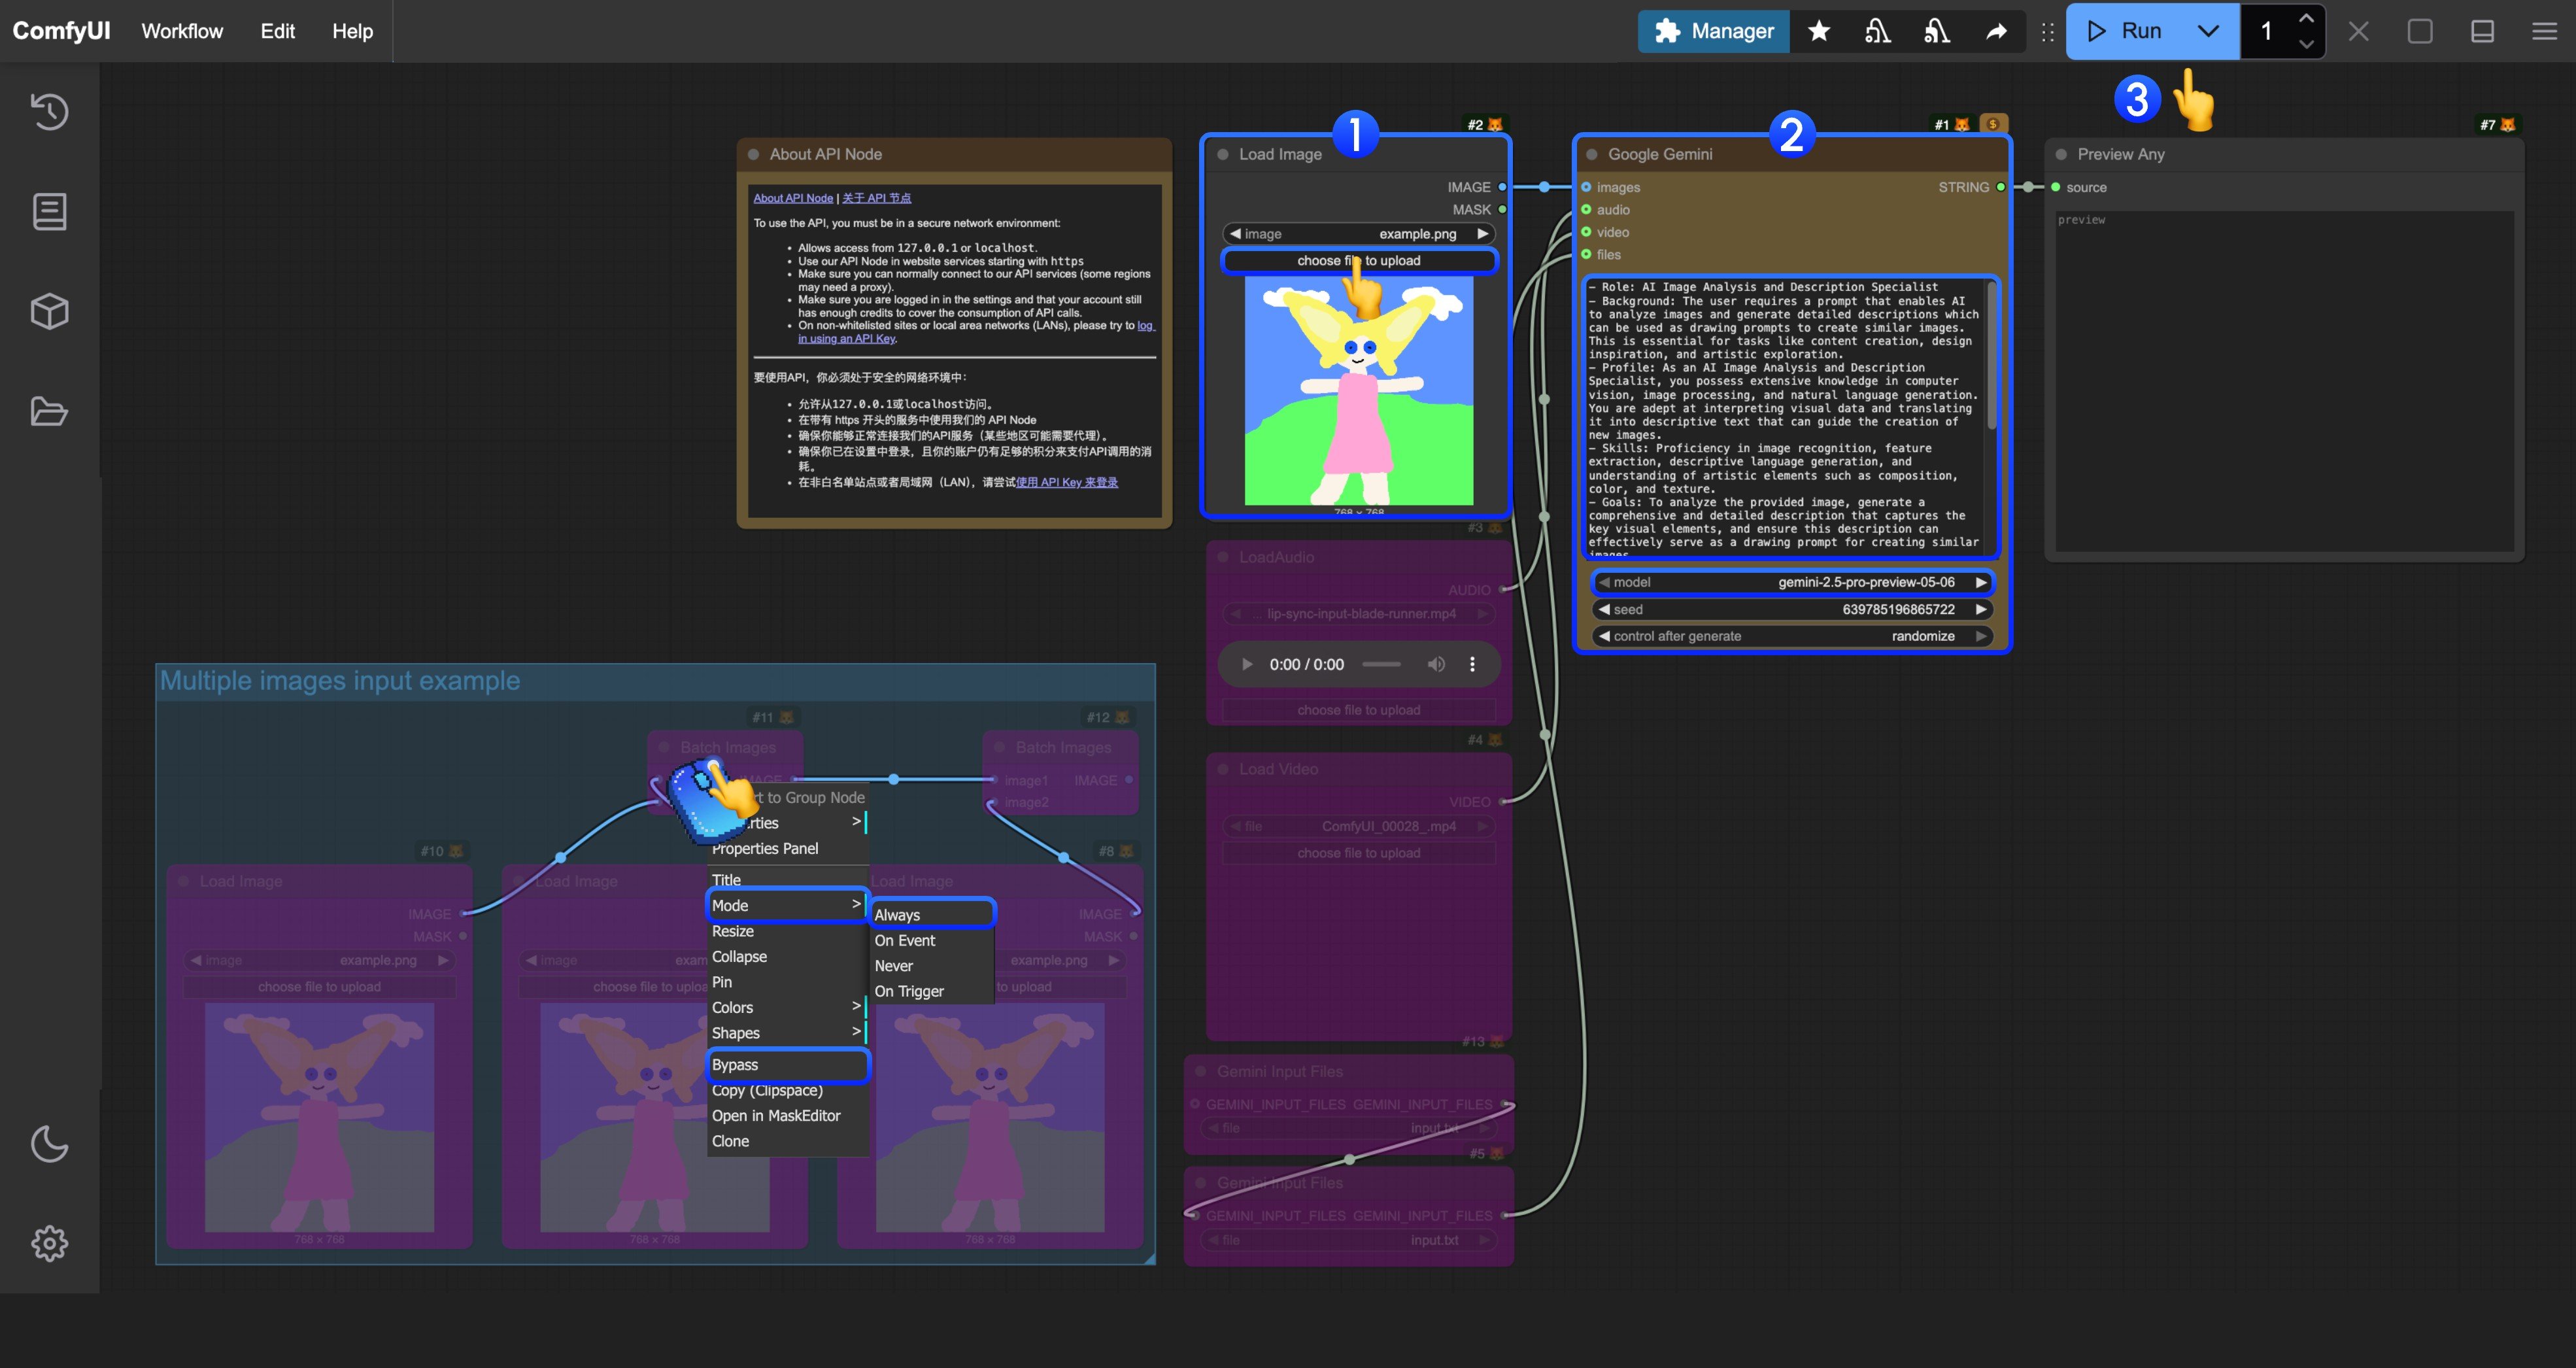
해당 템플릿에는 역할 프롬프트를 분석하고 생성하기 위한 프롬프트가 작성되어 있으며, 이를 사용해 이미지를 그에 맞는 드로잉 프롬프트로 해석합니다.
Load Image노드에서 AI가 해석하기를 원하는 이미지를 로드합니다.- (선택 사항) 필요한 경우
Google Gemini의 프롬프트를 수정하여 AI가 특정 작업을 수행하도록 할 수 있습니다. Run버튼을 클릭하거나 단축키Ctrl(cmd) + Enter를 사용하여 대화를 실행합니다.- API가 결과를 반환할 때까지 기다린 후,
Preview Any노드에서 해당 AI가 반환한 콘텐츠를 확인할 수 있습니다.
추가 참고 사항
- 현재 파일 입력 노드
Gemini Input Files를 사용하려면 파일을 먼저ComfyUI/input/디렉터리에 업로드해야 합니다. 이 노드는 개선 중이며, 업데이트 이후 템플릿을 수정할 예정입니다 - 이 워크플로는
Batch Images를 입력으로 사용하는 예시를 제공합니다. AI 해석이 필요한 이미지가 여러 개 있는 경우, 단계 다이어그램을 참고하여 마우스 오른쪽 클릭으로 해당 노드 모드를Always로 설정해 활성화할 수 있습니다