

프로젝트 리포지토리
GitHub의 ATI 소스 코드와 문서
온라인 트래젝터리 편집 도구
이미지 위에 모션 트래젝터리를 그리고 편집하는 시각적 도구
주요 특징
- 통합 모션 제어: 객체, 국소 영역, 카메라 움직임 등 여러 가지 모션 유형에 대한 트래젝터리 제어를 지원합니다.
- 인터랙티브 트래젝터리 에디터: 사용자가 이미지 위에 자유롭게 모션 트래젝터리를 그려서 편집할 수 있는 시각적 도구입니다.
- Wan2.1 호환: 공식 Wan2.1 구현을 기반으로 하며, 환경과 모델 구조와 호환됩니다.
- 풍부한 시각화 도구: 입력 트래젝터리, 출력 비디오, 트래젝터리 오버레이의 시각화를 지원합니다.
WAN ATI 트래젝터리 제어 워크플로우 예시
1. 워크플로우 다운로드
ComfyUI를 최신 버전으로 업데이트한 다음, 워크플로우 파일을 다운로드해 ComfyUI로 드래그하거나, 템플릿 라이브러리의Workflow → Browse Templates → Video에서 “Wan2.1 ATI”를 찾으세요.
Comfy Cloud에서 실행
Comfy Cloud에서 열기
워크플로우 다운로드
JSON을 다운로드하거나 템플릿 라이브러리에서 “Wan2.1 ATI”를 검색하세요
입력 이미지: video_wan_ati_input_image.jpg
기본 입력 이미지를 다운로드하거나, 원하는 이미지를 시작 프레임으로 사용하세요.
2. 모델 다운로드
이 가이드에 등장하는 모든 모델은 여기에서 찾을 수 있습니다. 디퓨전 모델 : 버전 중 하나를 선택하세요:Diffusion Model: Wan2_1-I2V-ATI-14B_fp8_e4m3fn.safetensors
Wan2.1 I2V ATI 14B 확산 모델(fp8 정밀도).
ComfyUI/models/diffusion_models/에 배치하세요.Text Encoder: umt5_xxl_fp16.safetensors
전체 정밀도 텍스트 인코더(품질이 높고 크기가 큽니다).
ComfyUI/models/text_encoders/에 배치하세요.Text Encoder: umt5_xxl_fp8_e4m3fn_scaled.safetensors
FP8 텍스트 인코더(VRAM 사용량이 적습니다).
ComfyUI/models/text_encoders/에 배치하세요.VAE: wan_2.1_vae.safetensors
Wan2.1 VAE 모델.
ComfyUI/models/vae/에 배치하세요.CLIP Vision: clip_vision_h.safetensors
참조 이미지 처리를 위한 CLIP Vision 모델.
ComfyUI/models/clip_vision/에 배치하세요.다음 모델 중 하나를 선택하세요: clip_vision 파일 저장 위치
3. 워크플로우를 단계별로 완료하세요
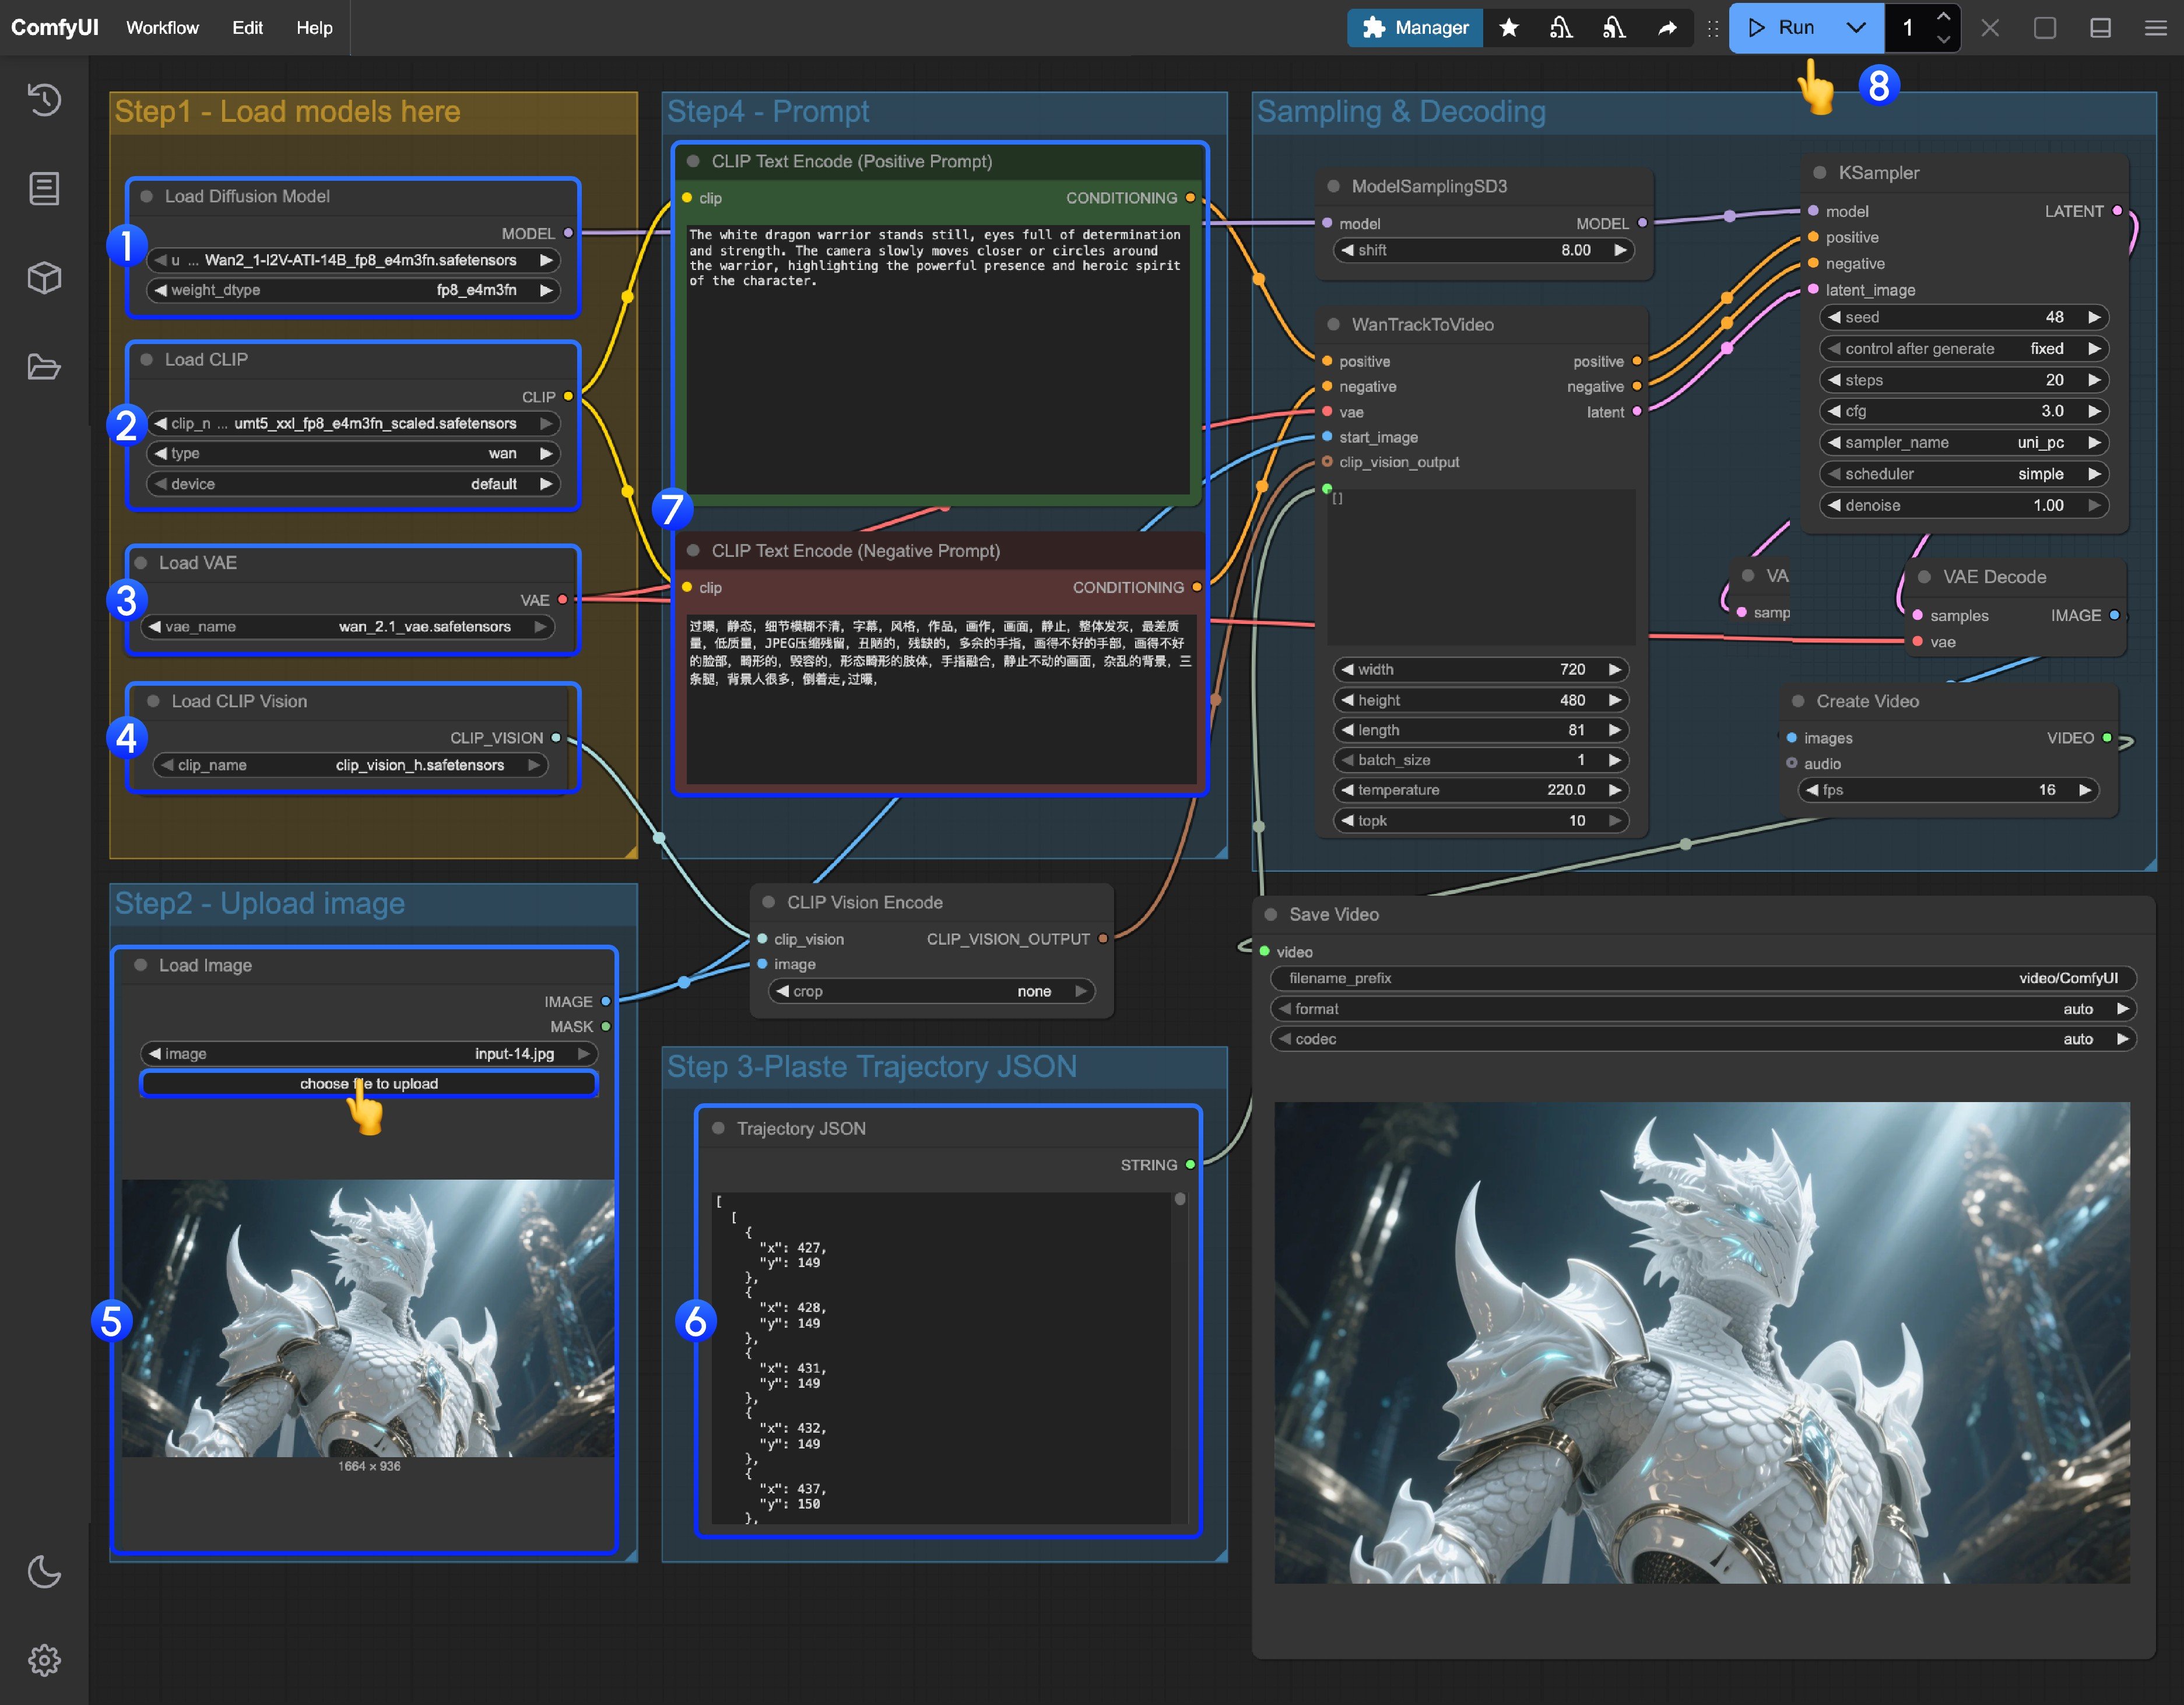
Load Diffusion Model노드가Wan2_1-I2V-ATI-14B_fp8_e4m3fn.safetensors모델을 로드했는지 확인하세요.Load CLIP노드가umt5_xxl_fp8_e4m3fn_scaled.safetensors모델을 로드했는지 확인하세요.Load VAE노드가wan_2.1_vae.safetensors모델을 로드했는지 확인하세요.Load CLIP Vision노드가clip_vision_h.safetensors모델을 로드했는지 확인하세요.- 제공된 입력 이미지를
Load Image노드에 업로드하세요. - 트래젝터리 편집: 현재 ComfyUI에는 해당하는 트래젝터리 에디터가 없으므로, 다음 링크를 이용해 트래젝터리 편집을 완료할 수 있습니다.
- 프롬프트(긍정 및 부정)를 수정해야 한다면, 번호
5의CLIP Text Encoder노드에서 변경하세요. Run버튼을 클릭하거나 단축키Ctrl(cmd) + Enter를 사용해 비디오 생성을 실행하세요.